Entenda os tipos de memória para agentes de IA, os trade-offs reais e as estratégias que equipes de engenharia usam em produção para manter respostas consistentes e escaláveis.
A memória é o que separa um chatbot genérico de um agente que realmente parece entender o usuário ao longo do tempo. Sem ela, cada interação recomeça do zero. Com ela mal implementada, o sistema fica lento, caro ou incoerente.
Engenheiros que constroem agentes de IA enfrentam decisões difíceis: quanto guardar, onde armazenar e como recuperar sem explodir o custo ou a latência. Este artigo explica as principais abordagens e os problemas que surgem quando o projeto vai para produção.
O que é memória em Large Language Models
Memória em LLM combina o conhecimento fixo do modelo (pesos treinados) com informações dinâmicas que o desenvolvedor injeta durante a execução.
O primeiro é estático e não muda sem fine-tuning. O segundo é flexível e determina a personalidade, o histórico e o contexto específico de cada usuário.
A diferença entre os dois define o que o agente consegue lembrar e o quanto custa manter esse estado.
Tipos principais de memória em agentes de IA
Quatro categorias dominam as implementações atuais. Cada uma resolve um problema diferente.
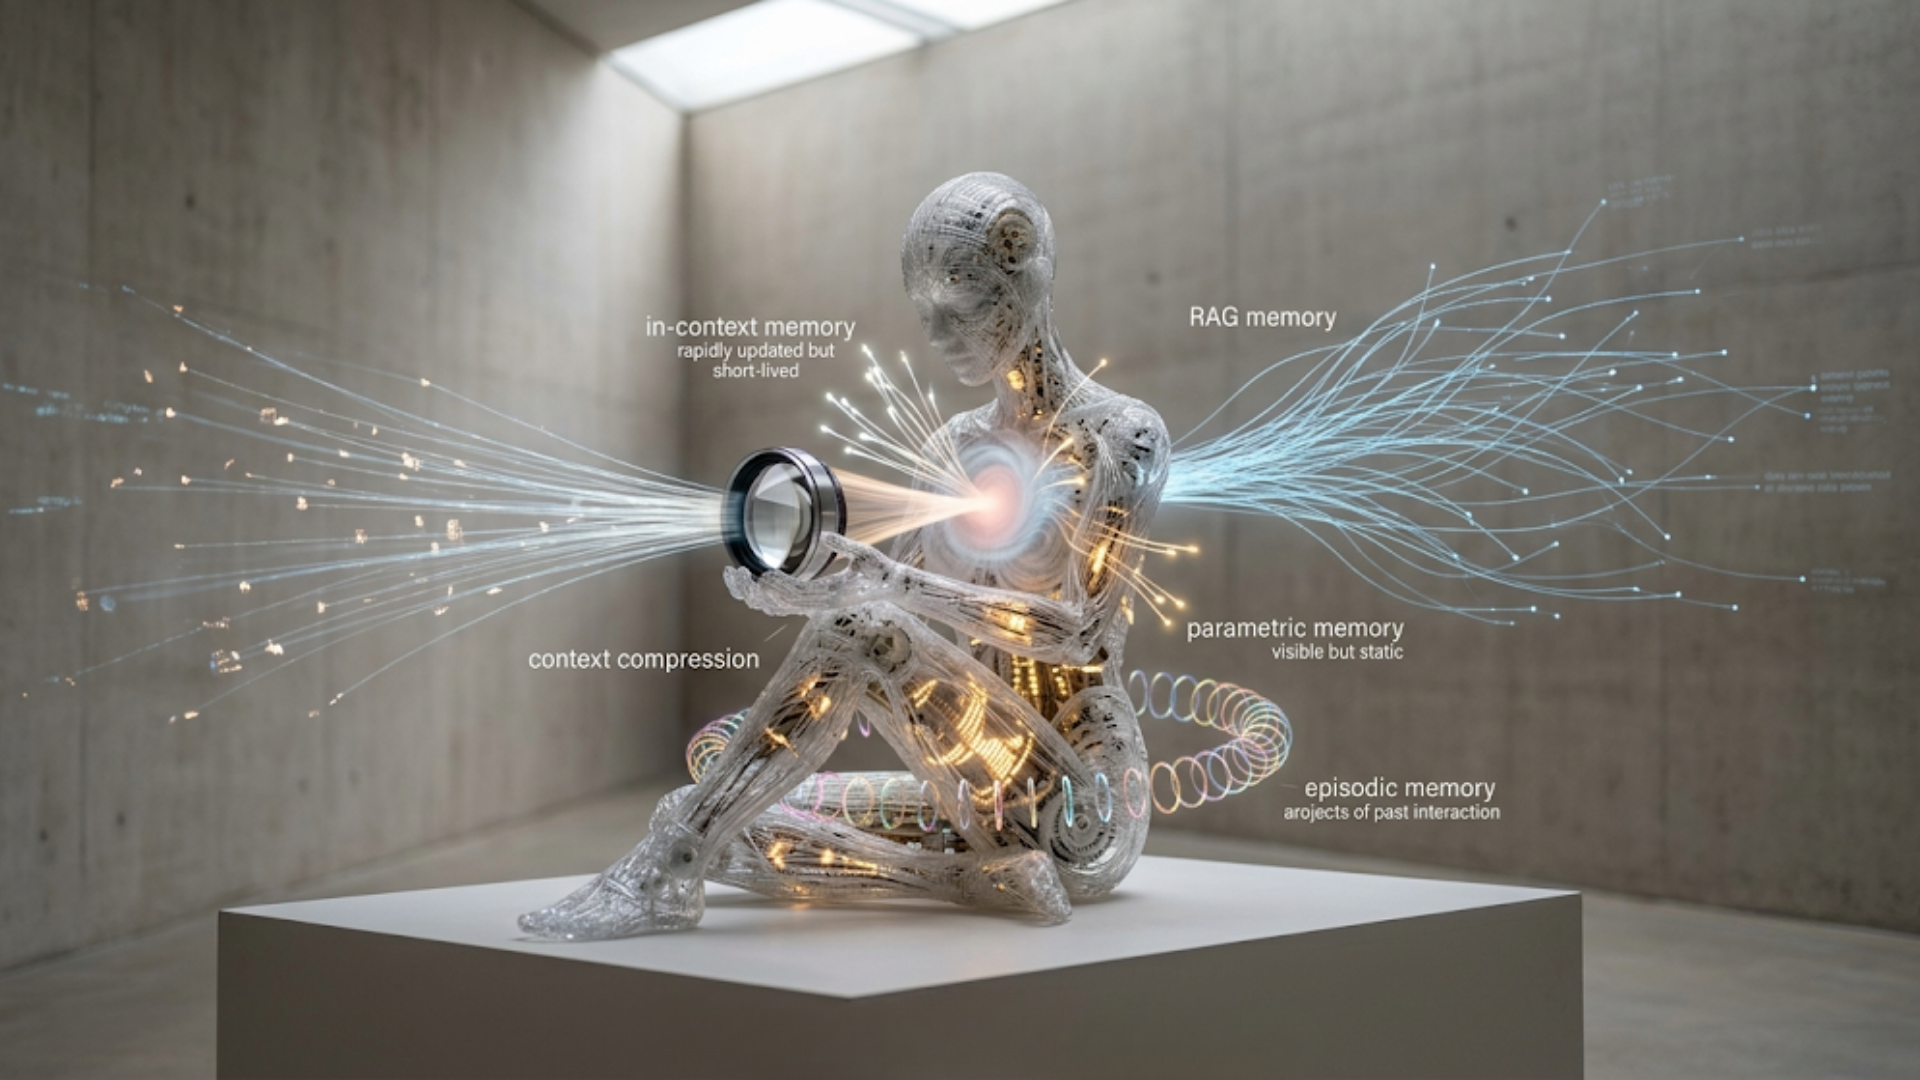
Memória em contexto (in-context)
Funciona dentro da janela de tokens da chamada. Inclui histórico recente da conversa e instruções do sistema.
Vantagem: precisão alta porque o modelo vê tudo de uma vez.
Limitação: a janela tem tamanho fixo. Conversas longas perdem detalhes do meio ou simplesmente não cabem.
Memória externa (external memory)
Armazena dados fora do prompt, geralmente em vector stores. Recupera apenas o relevante via busca semântica.
Permite escalar para volumes grandes sem aumentar o prompt inteiro.
Desafio: a qualidade depende totalmente da estratégia de chunking e embedding. Ruído na recuperação compromete a resposta.
Memória paramétrica
É o conhecimento embutido nos pesos do modelo durante o treinamento.
Zero latência adicional.
Problema: fica desatualizado rapidamente. Não serve para fatos recentes ou dados específicos do usuário.
Memória episódica
Guarda preferências, decisões passadas e histórico entre sessões diferentes.
Faz o agente parecer que “conhece” o usuário mesmo após dias.
Exige mecanismos de resumo e esquecimento para não crescer indefinidamente.
Estratégias de implementação que equipes usam em produção
RAG tradicional
Pipeline linear: query → busca vetorial → chunks relevantes → prompt.
Ideal para bases de conhecimento estáticas, como manuais internos ou documentação de produto.
Complexidade operacional: chunking, embeddings, latência de recuperação e monitoramento constante de relevância.
Agentic RAG
O próprio agente decide quando buscar, o que buscar e se precisa refinar a consulta.
Funciona melhor em tarefas complexas que exigem múltiplas etapas ou cruzamento de fontes.
Custo mais alto e mais difícil de depurar por causa do comportamento não-determinístico.
GraphRAG
Combina vector search com grafo de conhecimento que mapeia entidades e relacionamentos.
Excelente para perguntas que exigem visão geral ou conexões entre muitos documentos.
Mais caro para construir e manter, mas entrega respostas mais profundas em domínios interconectados.
Problemas comuns que aparecem em produção
Mesmo com arquitetura bem pensada, vários pontos de falha surgem quando o tráfego aumenta.
Contexto se perde no meio do prompt: Modelos tendem a dar mais atenção ao início e ao fim. Informações centrais desaparecem em tarefas longas.
Recuperação irrelevante em escala: Similaridade vetorial não é igual a relevância real. Chunks parecidos mas fora de contexto poluem o prompt.
Loops de desvio: Em agentic setups, um retrieval ruim pode fazer o agente seguir caminho errado e piorar a cada passo.
Crescimento descontrolado: Histórico sem compressão torna cada chamada mais lenta e cara.
Como mitigar esses riscos
Equipes experientes adotam algumas práticas consistentes:
– Resumir periodicamente conversas antigas em um estado compacto
– Usar hybrid search (dense + sparse) + re-ranker antes de injetar no prompt
– Implementar guardrails que interrompem o agente quando a confiança da recuperação cai
– Monitorar latência, custo por interação e taxa de respostas incoerentes em tempo real
3 listas essenciais para avaliar sua arquitetura de memória
Sinais de que sua memória está funcionando bem:
– O agente mantém tom e preferências consistentes entre sessões
– Respostas continuam rápidas mesmo após dezenas de interações
– Fatos específicos do usuário são lembrados sem alucinações
– Custo por conversa permanece previsível
Erros comuns que destroem performance:
– Salvar tudo no contexto sem compressão
– Usar apenas vector search sem re-ranking
– Não ter estratégia de esquecimento de dados antigos
– Ignorar monitoramento de relevância em agentic flows
Perguntas que todo time deve fazer antes de escolher a stack:
– Qual é o tamanho médio do histórico real dos usuários?
– Quantas buscas externas são necessárias por interação?
– O domínio exige relacionamentos complexos entre entidades?
– Qual é o orçamento aceitável de tokens e latência?
Por que memória bem feita muda o resultado final
Um agente sem memória adequada parece amnésico. Com memória excessiva ou mal gerenciada, fica lento e caro.
O equilíbrio certo cria experiências que parecem pessoais, úteis e confiáveis — exatamente o que diferencia produtos de IA que retêm usuários daqueles que são abandonados após poucas interações.
O segredo não está em usar o modelo mais poderoso, mas em projetar o sistema de estado com clareza, observabilidade e mecanismos de correção automática.