Nova abordagem da Amazon usa um modelo de linguagem para avaliar e melhorar respostas de IA de forma inteligente, entregando resultados mais precisos e alinhados para aplicações reais.
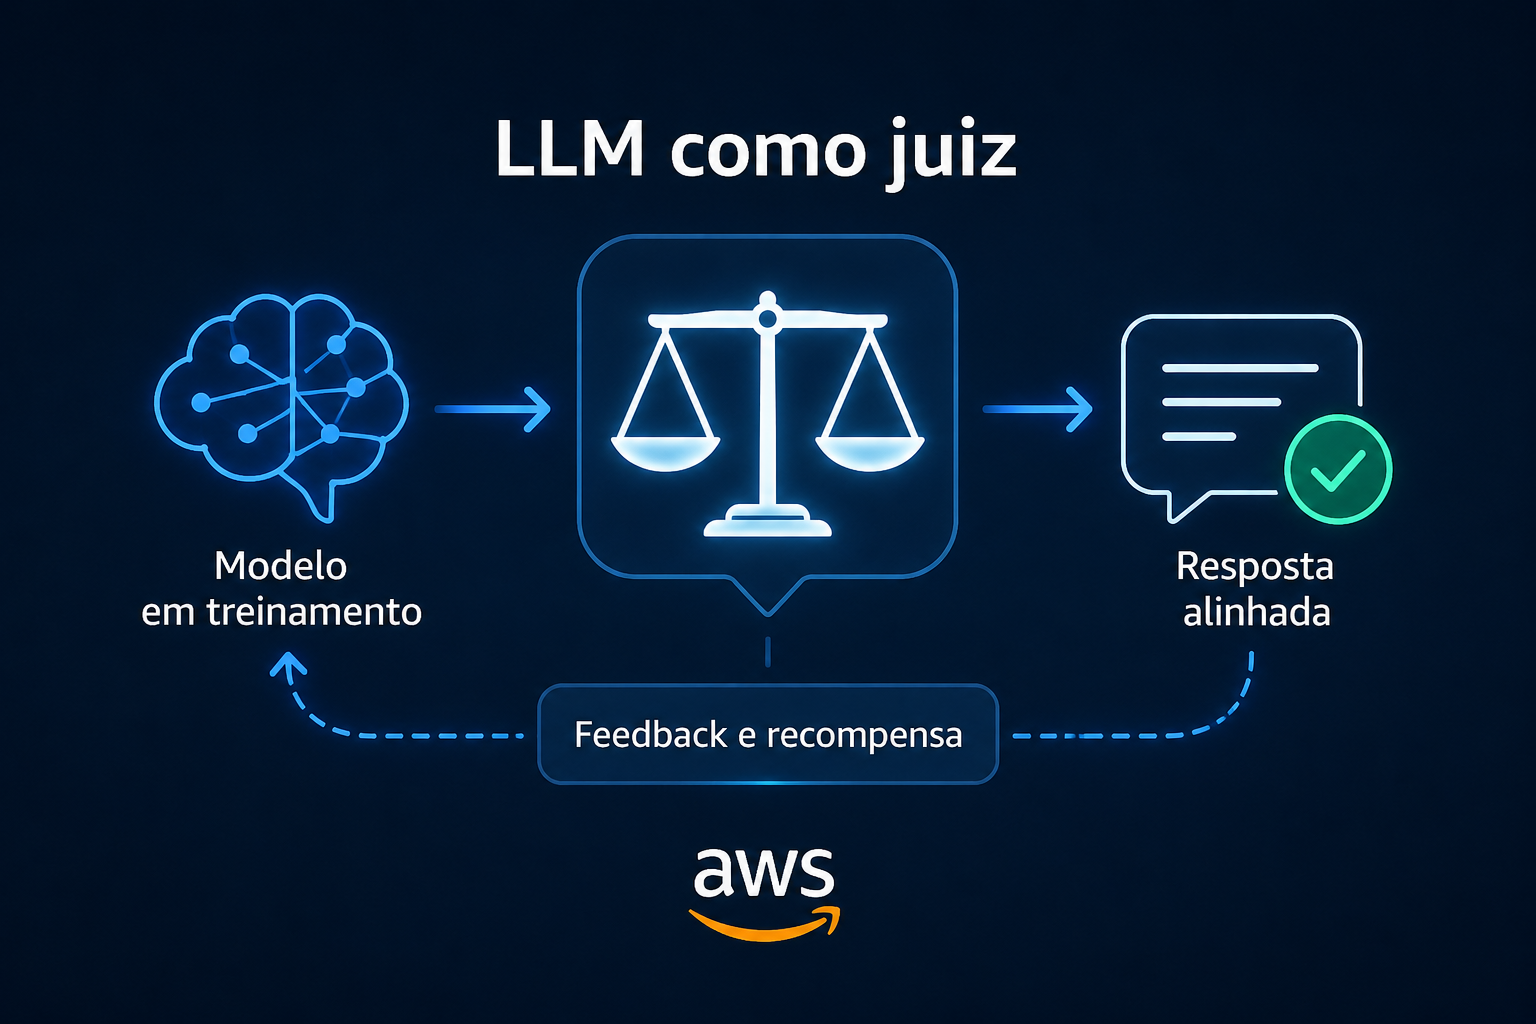
Ajustar modelos de linguagem grandes (LLMs) para tarefas específicas sempre foi um desafio caro e demorado. Respostas imprecisas, tom inadequado ou violações de políticas limitam o uso em produção. A Amazon Web Services apresentou uma solução prática: Reinforcement Fine-Tuning (RFT) com LLM-as-a-judge, que usa outro modelo de IA para atuar como juiz e guiar o treinamento.
Essa técnica permite alinhar modelos como os Amazon Nova de maneira mais eficiente, substituindo rótulos manuais caros por feedback automatizado e contextualizado.
Por que o RFT com LLM como juiz supera métodos tradicionais
Métodos antigos de fine-tuning supervisionado dependem de grandes volumes de dados rotulados por humanos. Já o Reinforcement Fine-Tuning usa sinais de recompensa para refinar o modelo durante o treinamento.
Com LLM-as-a-judge (também chamado RLAIF), um modelo separado avalia as saídas do modelo em treinamento. Isso traz flexibilidade para domínios complexos onde regras rígidas não capturam nuances como tom, relevância, segurança e precisão factual.
Diferente de recompensas baseadas em código simples (RLVR), o juiz LLM analisa múltiplas dimensões e fornece explicações sobre o porquê de uma resposta ser melhor. Essa transparência ajuda equipes a iterarem mais rápido e identificarem problemas específicos.
Seis passos essenciais para implementar LLM como juiz
Escolha a arquitetura do juiz
Existem duas abordagens principais:
- Julgamento baseado em rubrica: Atribui pontuação numérica ou booleana (aprova/reprova) a uma única resposta. Ideal quando você tem critérios claros e quantificáveis.
- Julgamento baseado em preferência: Compara duas respostas lado a lado e escolhe a melhor. Funciona bem quando o modelo precisa explorar livremente.
A rubrica com pontuação booleana costuma ser mais confiável e reduz variações indesejadas.
Defina critérios de avaliação claros
Seja específico sobre o que importa: precisão factual, clareza, adesão a políticas, tom amigável ou estrutura JSON, por exemplo. Use exemplos concretos no prompt do juiz para guiar as decisões.
Selecione o modelo juiz adequado
- Modelos maiores (como Nova Pro ou equivalentes) para avaliações complexas e multidimensionais.
- Modelos menores e mais leves para tarefas gerais como matemática ou código, equilibrando custo e desempenho.
Configure o juiz via Amazon Bedrock e integre em uma função Lambda para recompensas.
Refine o prompt do juiz
O prompt deve gerar saídas estruturadas, preferencialmente em JSON, para facilitar a extração automática da pontuação. Inclua regras claras para casos de borda e comportamentos desejados.
Alinhe o juiz com métricas de produção
Garanta que as dimensões avaliadas pelo juiz reflitam exatamente os objetivos de negócio. Valide a correlação entre pontuações do juiz e resultados reais em testes.
Construa uma função Lambda robusta para recompensas
Combine verificações determinísticas rápidas (formato, comprimento, segurança) com a avaliação do LLM para otimizar custos e estabilidade. Implemente backoff, paralelismo e tratamento de erros para evitar interrupções no treinamento.
Fluxo completo de treinamento com RFT
O processo envolve gerar múltiplas respostas (rollouts), avaliá-las com o juiz, calcular recompensas compostas e atualizar o modelo. Essa iteração contínua melhora o desempenho geral.
Testes mostram que modelos treinados com essa abordagem generalizam bem mesmo com critérios de juiz ligeiramente diferentes, evitando overfitting.
Estudo de caso: Revisão automática de contratos legais
Uma empresa do setor jurídico queria automatizar a análise de riscos em contratos novos, comparando com diretrizes internas e documentos de referência.
Desafio: Volumes altos de documentos complexos exigindo precisão jurídica.
Solução: Usaram RFT com LLM como juiz. O modelo recebia o contrato alvo, documentos de referência e gerava comentários estruturados em JSON (tipo de risco, trecho problemático, ação recomendada).
Resultados: Melhoria significativa em relação ao modelo base e ao fine-tuning supervisionado tradicional, especialmente em identificação precisa de problemas no texto do contrato (não apenas cópia de referências).
Vantagens práticas e considerações
- Explicabilidade: O juiz fornece rationale para cada pontuação.
- Flexibilidade: Adapta-se a domínios subjetivos ou que mudam com o tempo.
- Eficiência: Reduz dependência de anotação humana.
Custo de computação é maior devido aos rollouts múltiplos, mas vale para aplicações críticas como saúde, finanças e jurídico.
Dicas para começar:
- Valide o juiz em um conjunto de exemplos conhecidos.
- Combine recompensas determinísticas com LLM para eficiência.
- Monitore consistência do juiz e possíveis drifts.
- Teste generalização com critérios variados.